 复制
2026年10月22日,宇树创始人王兴兴在杭州国际博览中心世界物理AI大会上,以《相信,尽可能相信AI》为题发表演讲,一句“全世界几乎所有人对AI的信仰都不够”引发热议。作为科创板上市企业掌舵人,他直言过往对AI相信不足,抛出重磅判断:具身智能的ChatGPT时刻最快明年可能到来,当前最大瓶颈并非算力数据,而是虚拟智能与物理执行的“对齐”难题。
2026年10月22日,在杭州国际博览中心举办的世界物理AI大会上,宇树创始人王兴兴以《相信,尽可能相信AI》为题发表演讲,一句“全世界几乎所有人对AI的信仰都不够”引发热议。作为科创板上市企业掌舵人,他直言自己过往对AI的相信程度不足,并抛出重磅判断:物理AI“具身智能的ChatGPT时刻”最快明年就可能到来,而当前最大瓶颈并非算力数据,而是虚拟智能与物理执行的“对齐”难题。
2026年10月22日,杭州国际博览中心。王兴兴站在2026世界物理AI大会的主论坛上,演讲的标题只有五个字:《相信,尽可能相信AI》。
他开场的第一句话,不是讲产品,不是讲技术,是讲“信仰”。
“全世界几乎所有人对AI的重视程度或者说信仰,其实都不是特别够,包括我自己。”
这句话从一位刚刚带领公司登陆科创板、市值一度突破四千亿的创始人嘴里说出来,分量不同寻常。它不是谦辞,是一个对自己认知的反复校准。
一、“信仰不够”:一个被数据验证的判断
王兴兴的“信仰不够”,有具体的支撑。
他在演讲中给出了一个关键观察:对于最顶尖的大模型公司,某种意义上,内部已经基本实现了模型的自进化。模型自己写程序、自己采集数据,人只需要适当的参与和引导。
这不是一个理论推演,是一个正在发生的事实。王兴兴在大会现场展示了宇树使用GPT-6进行机器人训练的视频:机器人可以在零训练的情况下,完成绘画、规划导航等任务。
“零训练”这三个字,是理解“自进化”含义的钥匙。 过去的模型需要针对特定任务进行大量标注和微调,而具备自进化能力的模型,正在从“被训练”走向“能学习”。当模型可以自己写代码、自己采集数据、自己迭代能力时,模型能力的提升曲线就不再是线性的,而是加速的。
王兴兴的判断很直接:“未来几个月或者一两年,模型能力的提升还会持续加速,而不是减速。”
这意味着,那些仍然用“一年前的大模型能力”来评估AI潜力的人,正在系统性地低估技术演进的速度。王兴兴把自己的反思说得很坦率:过去十几年犯的最大的错误,就是对AI的相信还不太够。
二、物理AI的“击穿”:一个比大多数人预期更近的时间表
王兴兴演讲中最重要的判断,是关于物理AI的时间窗口。
“物理AI目前已经看到被击穿的苗头。很可能是最近1至2年或2至3年。”
他把这个临界点定义为“具身智能的ChatGPT时刻”:在80%左右的陌生场景中,通过语音或语言指令,机器人能够顺利完成80%左右的主要任务。
这个定义的精妙之处在于,它衡量的不是“机器人在实验室里能做什么”,而是“机器人在真实世界里能做什么”。“陌生场景”和“80%的任务”两个条件叠加,指向的是泛化能力——不是把一件事做到完美,而是在没见过的事情面前,也能找到合理的应对方式。
王兴兴给出的时间预期,比他此前公开的判断更加激进。2026年8月,他在世界机器人大会上给出的窗口是“快则2到3年,慢则5到10年”。两个月后,这个窗口被压缩到了“1至2年或2至3年”,而且他明确表示:“最快明年都很有可能”。
时间表的压缩本身,就是一个信号。 当一位身处产业最前沿的创始人,在两个月内把同一个判断的预期大幅提前时,说明他看到的进展速度,超出了他自己此前的模型。
三、最大的瓶颈:不是算力,不是数据,是“对齐”
但王兴兴并没有停留在乐观叙事里。他给出了一个极其具体、也极其困难的瓶颈。
“目前尚待解决的问题,主要是AI模型的输入输出和真实的机器人的对齐问题。”
“对齐”这个词在AI领域通常指模型行为与人类价值观的一致,但王兴兴用的是它的物理含义:虚拟世界里的智能,和物理世界里的执行,之间存在一道系统性的误差。
他在此前的演讲中解释过这道误差的来源:语言模型是纯数字编码,输入输出基本无损耗;但机器人每一次输入输出,都会在物理层面引入偏差与损耗。触觉层面的细微误差无法被模型修正,任务成功率随之暴跌。
更具体地说,当前的模型在固定场景中经过充分训练后,任务成功率可以接近100%。但一旦更换操作物品或稍微改变环境,成功率就会大幅下降。模型“知道该做什么”,但机器人“做出来的动作”和模型“以为会做出的动作”之间,存在一道无法被软件弥补的鸿沟。
这道鸿沟,才是物理AI真正的“叹息之墙”。它解释了为什么王兴兴一方面说“击穿在即”,另一方面又说“竞争会非常惨烈”——临界点很近,但跨越临界点的难度极高。
四、中美路径的分野:仿真、众包与真机工厂
王兴兴的“对齐”判断,恰好对应了当前中美在物理AI数据基础设施上的根本分歧。
美国押注的是“虚拟世界”和“众包数据”。 英伟达的Omniverse和Cosmos用仿真生成训练数据,Figure AI等公司通过众包收集人类行为视频。这条路径的逻辑是:真实机器人数据太贵太慢,用仿真和人类数据来替代。但仿真永远是对物理世界的简化,众包数据存在标注和清洗的“税负”。美国路线在“广度”上有优势,在“精度”上受制于对齐问题。
中国押注的是“真机工厂”和“物理数据”。 截至2026年6月,全国已建成超70家具身智能训练场,在建40多家。这些训练场把真实的家庭、工厂、厨房场景1:1搭建出来,让机器人一遍遍练习,用真机遥操作采集包含完整力觉、触觉和视觉同步的数据。
真机数据的价格并不便宜。国内真机数据约500元至1000元人民币每小时,海外数据则超过600美元每小时,价差近10倍。但王兴兴的“对齐”判断揭示了真机数据的不可替代性:只有真实物理世界的数据,才能训练出能在真实物理世界里稳定执行任务的模型。仿真数据可以教会模型“物理规律是什么”,但教不会模型“这个特定机器人的关节在负载下会偏移多少”。
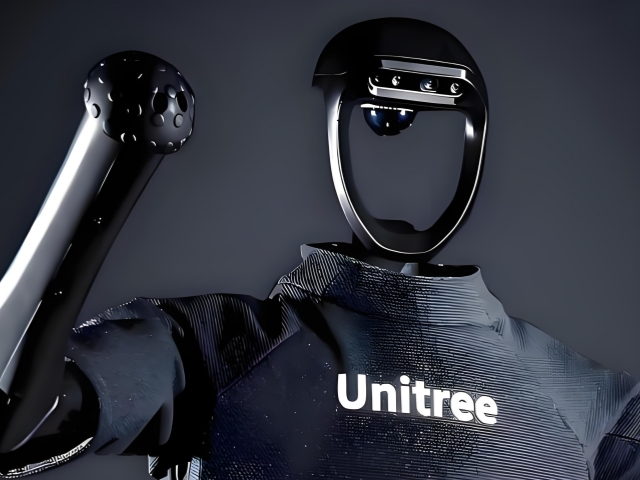
王兴兴给宇树设定的目标,是在2027至2028年让搭载物理AI大模型的机器人取得显著技术突破,进入家庭。宇树正在预研“物理AI机器人自进化V1.0”大模型,依托前沿大模型设定规则和边界,由模型自主检索论文、生成机器人控制代码。“自进化”在物理AI里的含义,是模型不再需要人类工程师逐行调整机器人的动作参数,而是自己完成从认知到执行的闭环。 这个闭环能否在两年内跑通,直接决定王兴兴的时间表是激进还是保守。
五、对产业的含义:竞争惨烈,瓶颈在“制造”与“对齐”
王兴兴在演讲中,对行业未来的关键要素给出了一个排序:机器人硬件的大规模生产制造能力(年產千万台)、自研或合作物理AI模型及落地、超大规模算力服务器以及算力和存储芯片制造能力。数据、算力、芯片产能、能源和矿,都是关键。
他把“制造能力”放在第一位,不是偶然。物理AI的“对齐”问题,不仅是一个算法问题,也是一个工程一致性问题。如果每一台机器人的关节间隙、传感器响应和装配精度都存在差异,模型在A机器人上学到的对齐参数,在B机器人上就无法复用。 只有制造能力达到极高的精度和一致性,模型的对齐才有可能在规模化部署中保持稳定。
而“年產千万台”这个量级,指向的是一个更宏大的产业图景:当机器人的制造规模达到千万台级别时,物理AI的数据采集、模型迭代和成本下降都将进入一个完全不同的正反馈循环。规模本身就是对齐问题的解法之一——足够大的部署基数,意味着足够多的真实世界误差样本,模型可以在这些样本中学习如何修正偏差。
六、王兴兴的“信仰”,是一个关于时间差的赌注
王兴兴的演讲,核心逻辑是一条清晰的时间线。
短期(现在到2027年): 模型自进化持续加速,物理AI在1至2年内看到被击穿的苗头。但“对齐”瓶颈尚未解决,机器人主要在商业服务、科研教育等场景落地,进入家庭和复杂工业场景仍需时间。
中期(2027至2028年): 宇树的目标是让搭载物理AI大模型的机器人取得显著技术突破,进入家庭。GPT-7的发布可能成为另一个加速节点。
长期(2028年之后): 如果物理AI被“击穿”,竞争将非常惨烈。决定胜负的,不是单一模型能力,是制造规模、数据闭环、算力供给和能源保障的系统性能力。
王兴兴说“我害怕浪费每一天”。这句话不是修辞,是一个身处产业临界点的人的真实状态。他看到的东西比大多数人更近,所以他比大多数人更急。
物理AI的“ChatGPT时刻”是否会在明年到来,没有人能给出确定的答案。但王兴兴给出的判断框架是清晰的:瓶颈不在模型能力本身,在模型与真实世界之间的那道“对齐”的窄门。
而跨过那道窄门所需要的,不仅是更聪明的模型,是更精密的制造、更真实的数据,以及一个愿意为“可能很快到来”提前下注的产业生态。